
Какие слои что знают: сравниваем RWKV-7 и трансформеры послойными пробами
- Words
- 325
- Chars
- 2119
- AI summary
- Yes
A layer-by-layer probe study asks where a language model stores word order, grammar and meaning, and whether this depends on architecture. Twelve small models that differed only in architecture were trained, and linear probes were run on every layer of every checkpoint. At this scale, the clearest difference appeared in how token position is stored, while syntax and meaning looked similar across models with equal loss.
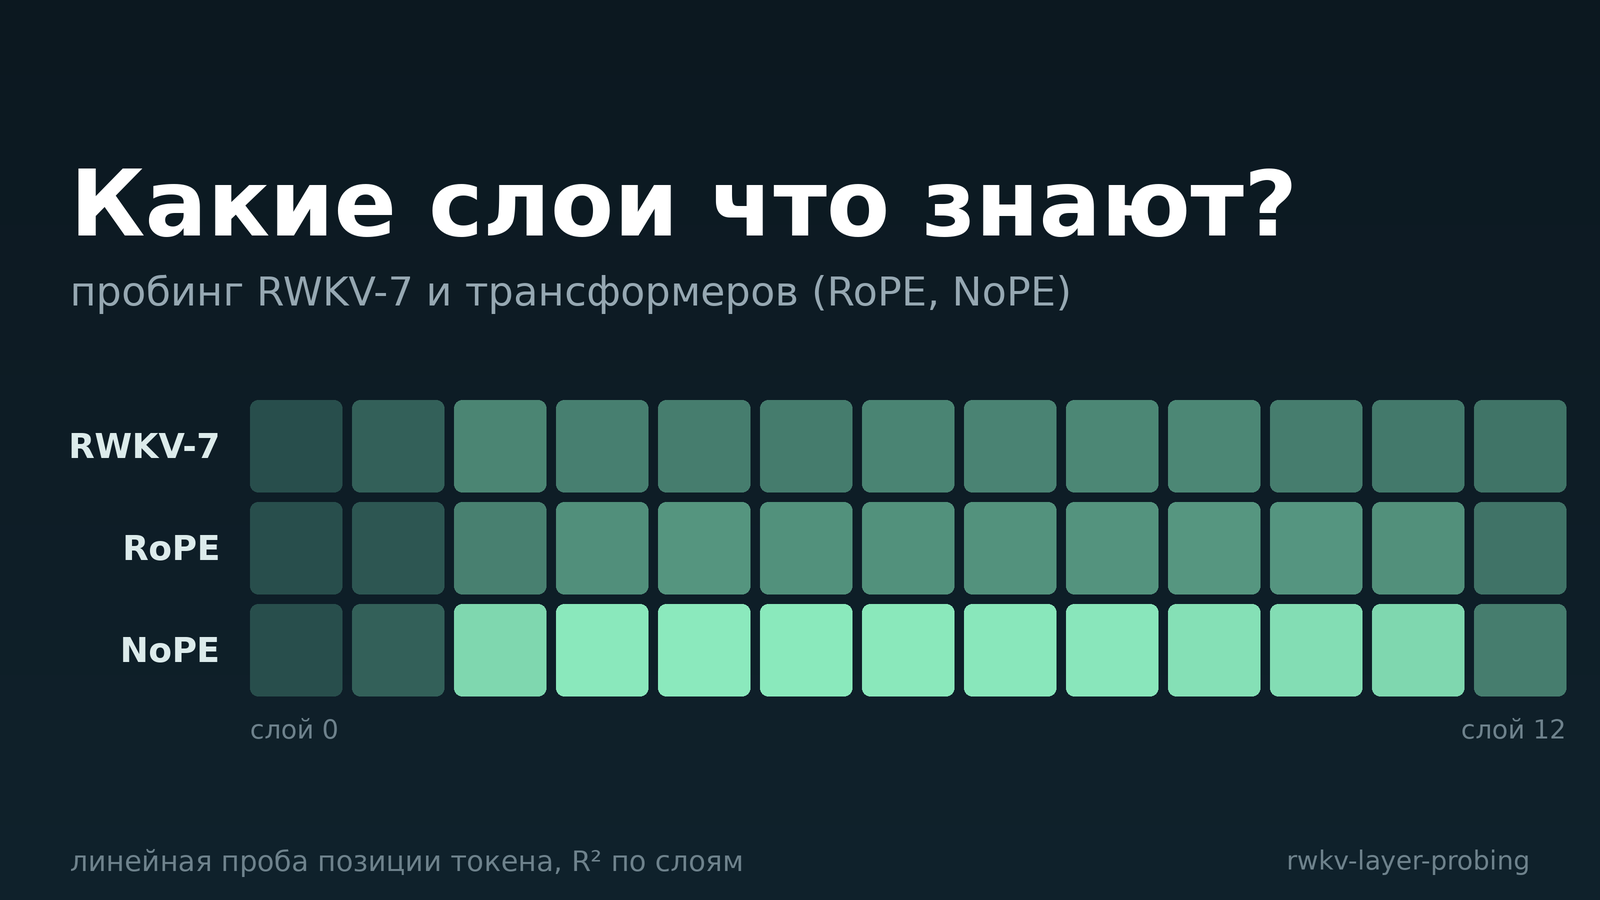
Где языковая модель хранит порядок слов, грамматику и смысл — и зависит ли это от архитектуры? Я обучил 12 небольших моделей, которые отличаются только архитектурой, и проверил линейными пробами каждый слой каждого чекпоинта. Короткий вывод: на этом масштабе заметнее всего различается то, как хранится позиция токена , а для синтаксиса и смысла модели при равном loss выглядят похоже. Сравнивал RWKV-7 , трансформер с RoPE и трансформер без позиционного кодирования (NoPE) . Размеров два (56.6M и 115M параметров), языков два (русский, английский), на модель 1–2 млрд токенов, по 21 чекпоинту на прогон, у 9 из 12 прогонов есть второй сид инициализации. Позицию токена линейная проба считывает из NoPE почти идеально, из RoPE заметно хуже, из RWKV ещё хуже (R² от log(1+t) на лучшем слое: 0.99 / 0.38–0.51 / 0.29–0.42 ). Это воспроизводится на обоих языках, обоих размерах и обоих сидах. Глубина слова в дереве зависимостей даёт тот же порядок, но с гораздо меньшим разрывом (0.02–0.06). Всё остальное — не больше 0.02–0.03 или в пределах разброса между сидами. У RWKV пик «синтаксических» проб приходится на слои на 1–4 ниже, чем у трансформеров, но это наводка, а не результат (подробности ниже). ...
Open article