
Независимые как понятия, зависимые как операции: параметры семплирования в LLM-инференсе
- Words
- 57
- Chars
- 472
- AI summary
- Yes
Large language model inference infrastructure is usually tuned for throughput and latency through KV caching, CUDA graphs, batching, quantization and parallelism. These components form the system’s backbone and define its performance limits. But sampling parameters—the rules that govern generation—often receive less attention even though they shape output quality rather than speed.
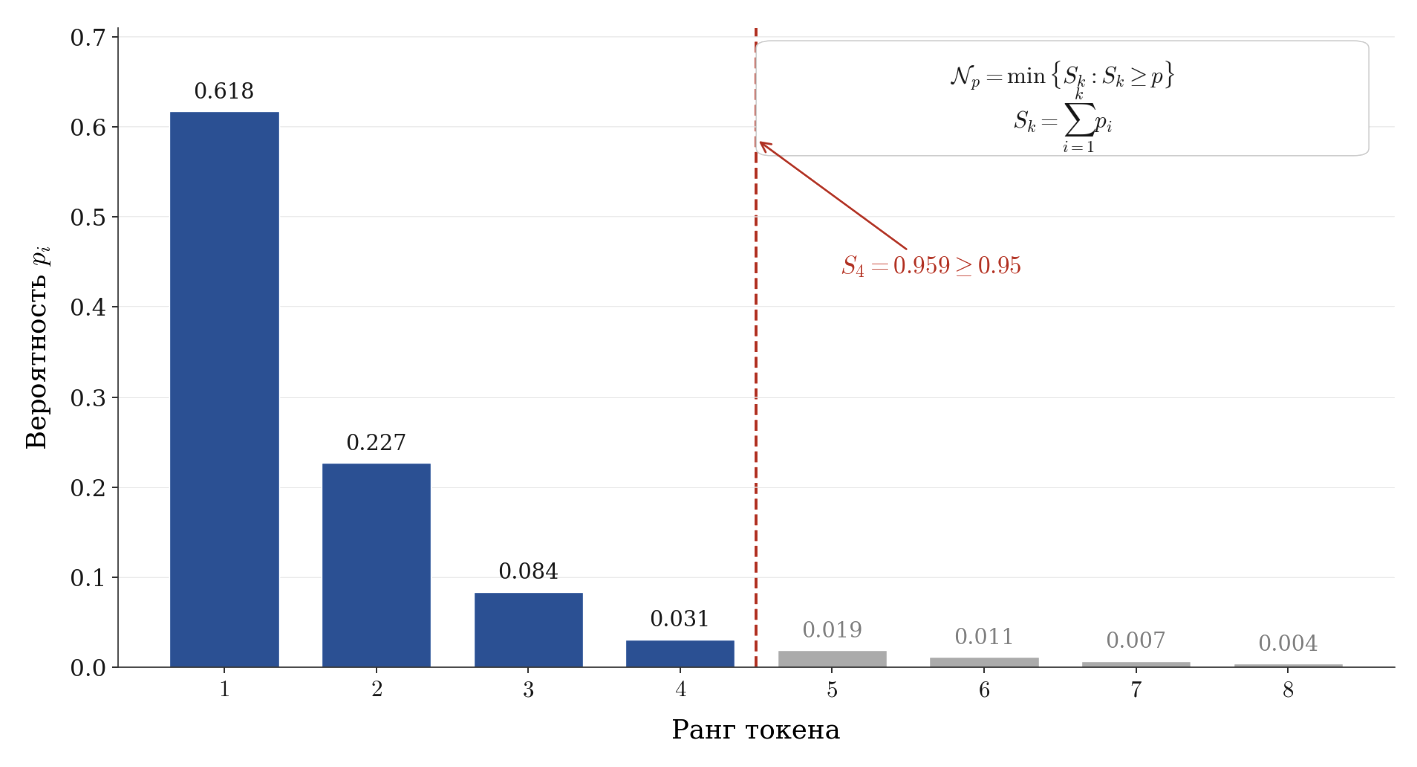
Инфраструктура вывода больших языковых моделей традиционно оптимизируется по пропускной способности и задержке: KV-кэш, CUDA-графы, батчинг, квантизация, параллелизм. Эти компоненты формируют «скелет» системы и задают её предельные характеристики. Однако на периферии внимания нередко остаётся слой, определяющий не скорость, а качество - параметры семплирования, то есть правила выбора следующего токена из распределения логитов на каждом шаге декодирования. Читать далее
Open article