
Квантование RWKV-7: что ломается в моделях разного размера
- Words
- 277
- Chars
- 1746
- AI summary
- Yes
A study examined post-training quantization for the RWKV-7 family, covering models from 0.1B to 13.3B parameters, using two presets. REDUCTION compresses by about 2.1x with almost no loss, while COMPRESSION compresses by about 3.1x at 4 bits per projection. The starting question was why the 4-bit preset degrades the 2.9B model more than the 1.5B model, with perplexity rising 4.04% versus 2.85%. It found that up to 86% of the o_proj group's contribution in the 2.9B model came from one component.
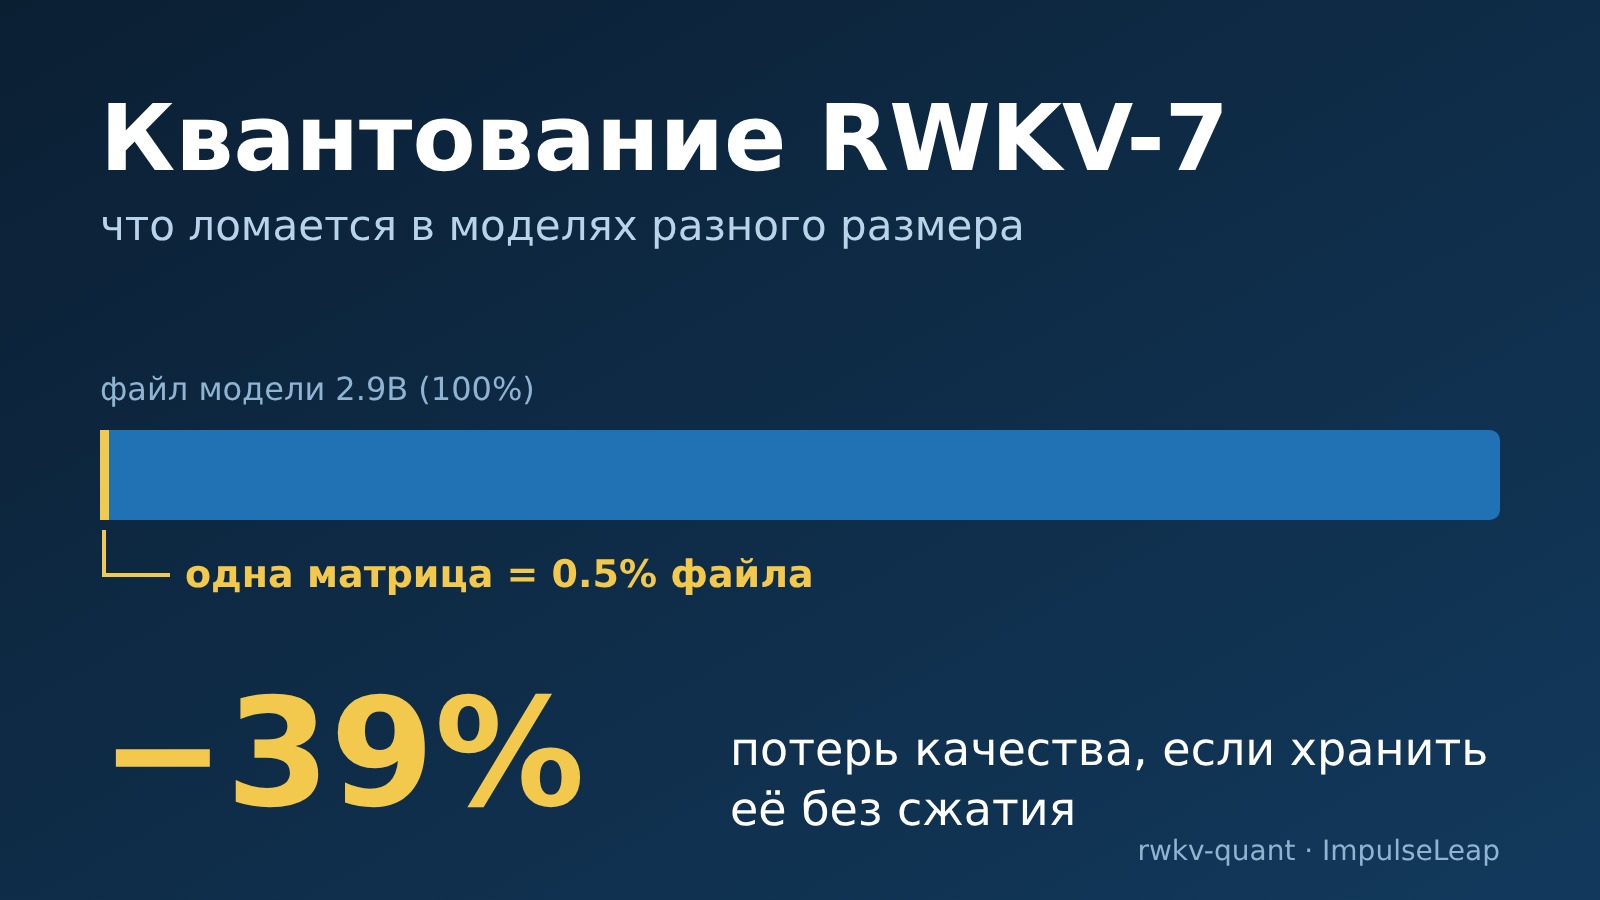
Я изучаю посттренировочное квантование семейства RWKV-7 (от 0.1B до 13.3B параметров) двумя пресетами: REDUCTION (сжатие около 2.1x, почти без потерь) и COMPRESSION (около 3.1x, 4 бита на проекции). Исходный вопрос работы: почему 4-битный пресет на модели 2.9B деградирует сильнее, чем на 1.5B (+4.04% против +2.85% по перплексии), хотя ожидается обратное. Оказалось, что до 86% вклада всей группы o_proj на 2.9B приходится на одну матрицу: выходную проекцию нулевого блока. Её вход несёт «массивный канал» (98% энергии входа в восьми каналах из 2560). Хранение этой одной матрицы в bf16 (0.5% файла) снижает KL к эталону на 39% и возвращает 2.9B в монотонную линейку; перевод эмбеддинга с 5 на 6 бит добавляет ещё −22% KL за 1.1% файла. Три естественные локальные метрики ошибки не предсказывают вред от квантования матрицы; предсказывает ошибка, внесённая в остаточный поток и умноженная на усиление ниже по глубине. На этом основании я строю автоподбор битности по правилу «снятый вред на байт» (−16…−39% KL при приросте файла не более 0.5%) и переношу GPTQ на ту же сетку (−29…−43% KL при тех же байтах). Вместе методы дают потерю по перплексии от +2.76% (0.1B) до +0.70% (13.3B) на файле размеро...
Open article