
Arca: мой взгляд на то, как генеалогическому софту следует подходить к хранению данных
A few years ago the author decided to start building their own family tree. They tried various existing genealogy tools and were not impressed. The author says most of these tools had interfaces that left a lot to be desired, and most also assumed that information about all of a user’s close relatives would be stored somewhere else. The excerpt cuts off before specifying where that data would be kept.
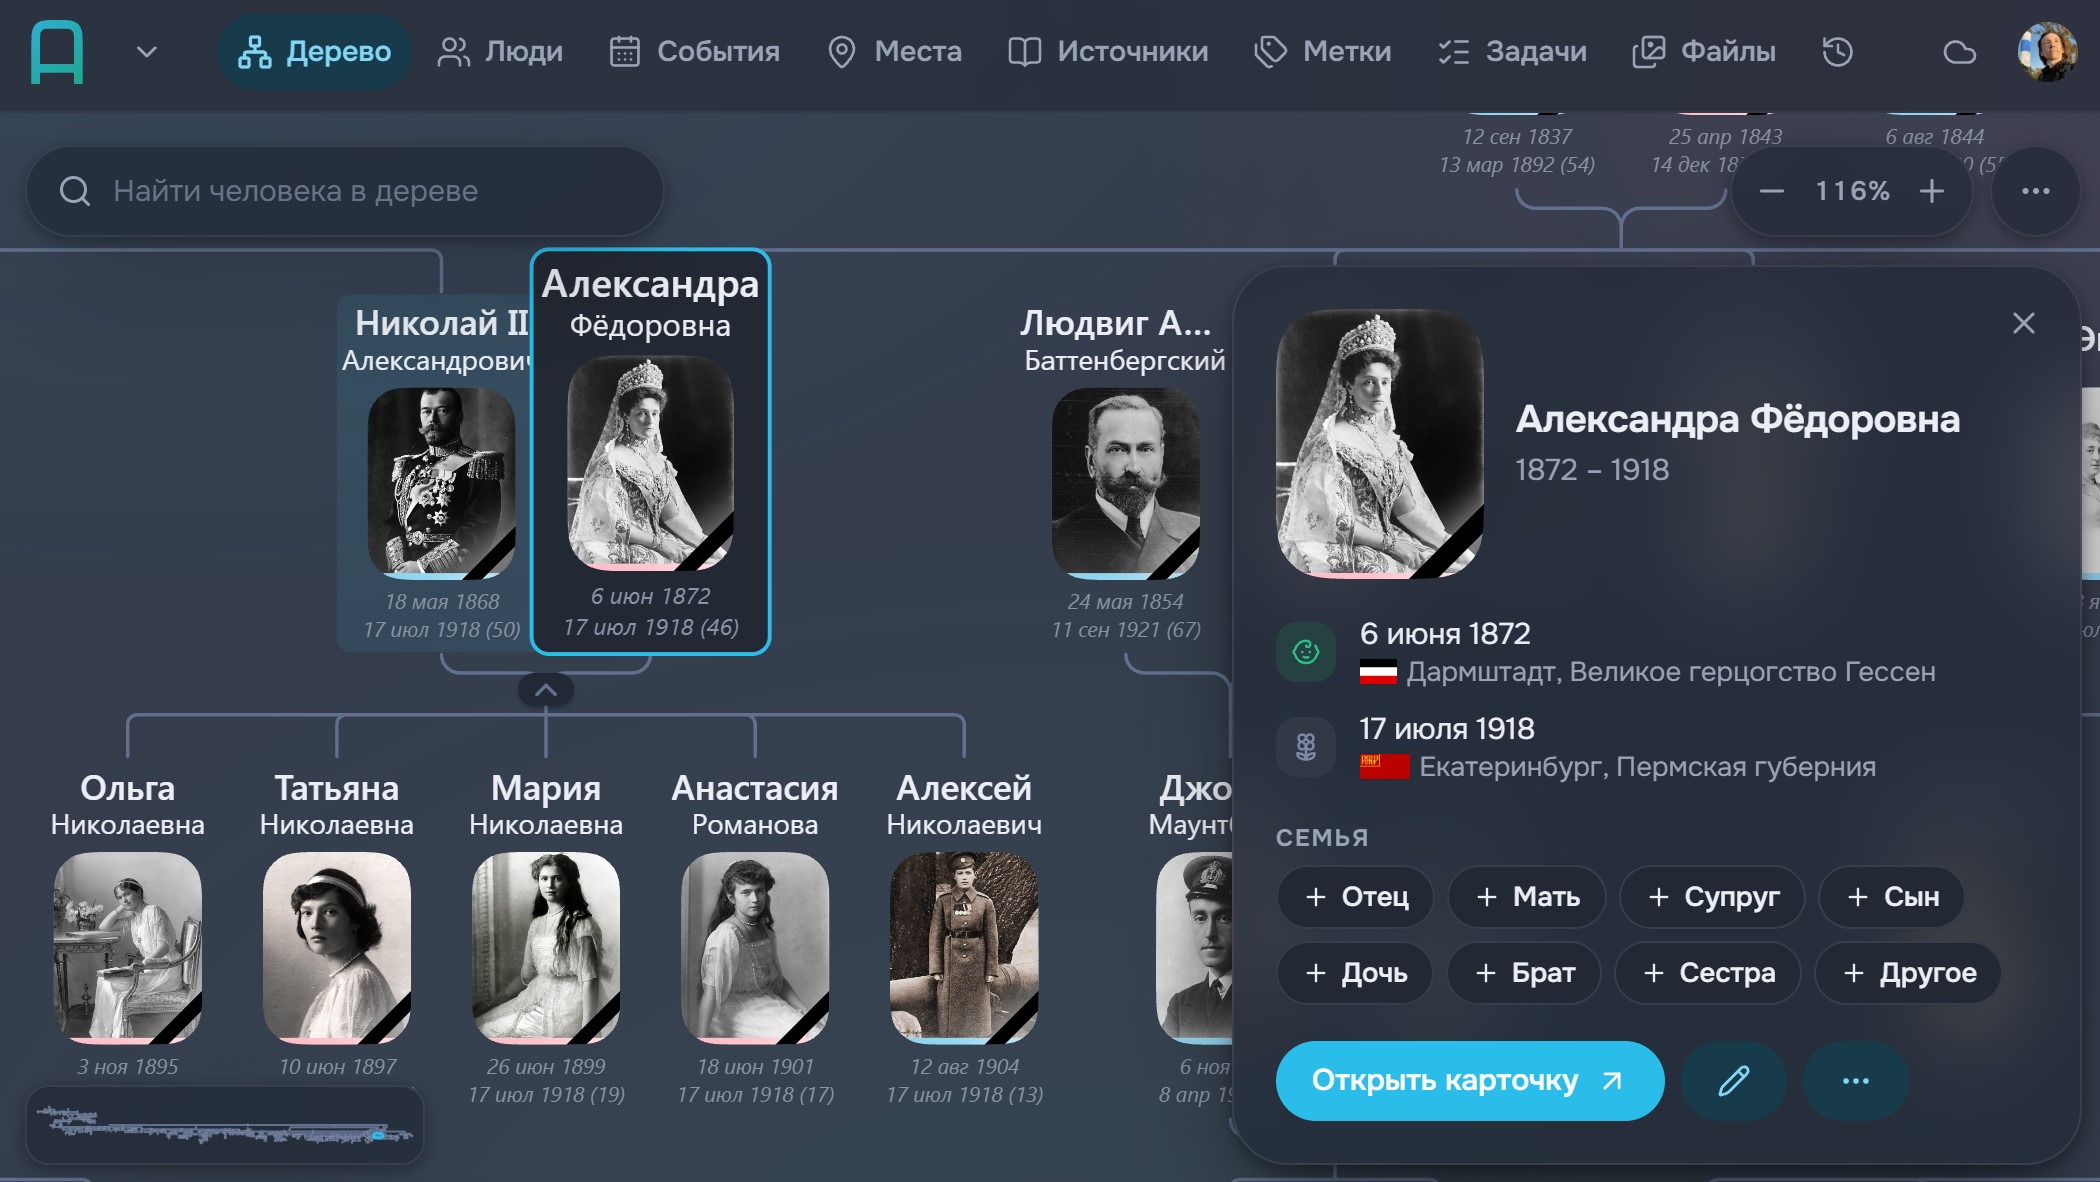
Несколько лет назад мне захотелось заняться составлением своего генеалогического древа. Я опробовал различные существующие инструменты для этого и не могу сказать, что остался в большом восторге. Во-первых, у подавляющего числа из них интерфейс, мягко говоря, оставлял желать лучшего, а во-вторых, большинство из них подразумевало хранение информации о всех своих близких где-то на серверах этих сервисов (причём ряд из них сейчас вовсе недоступен напрямую из России, что удобства не добавляет). Разумеется, как у любого уважающего себя разработчика, у меня зачесались руки написать собственное решение. Благо в целом задача не выглядела сверхмасштабной, ведь хранилище семейной истории — это по сути небольшая БД с 6-8 типами сущностей и визуализатором связей между ними. Но, как это нередко бывает, идея застряла на стадии раннего прототипа, и только сейчас, благодаря помощи LLM её удалось довести до относительно законченного вида. Ниже расскажу, что получилось и чем же именно мой сервис — я назвал его Arca — существенно отличается от других подобных решений. Кроме особенностей хранения проектов также затрону несколько других любопытных нюансов — выбранный мной подход к локализуемому представлению имён, а также исторических названий городов и регионов. Читать далее