
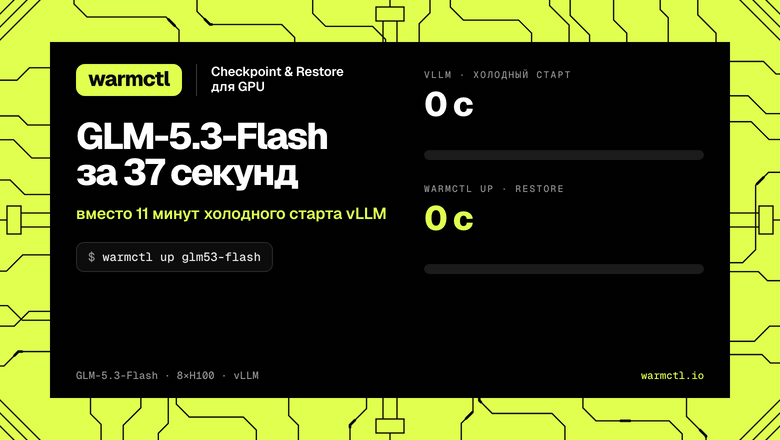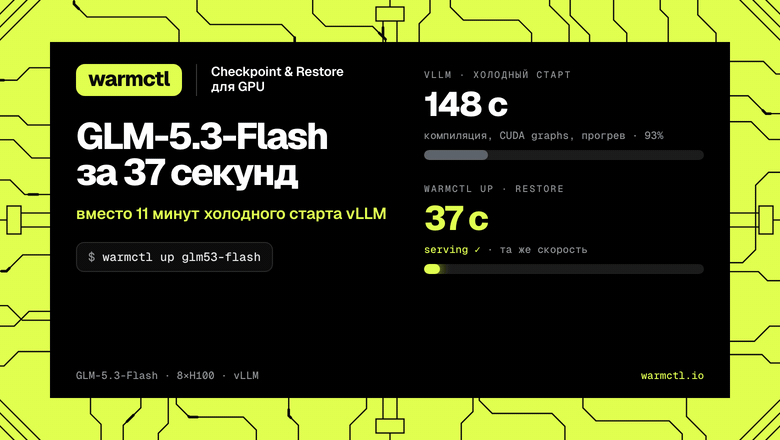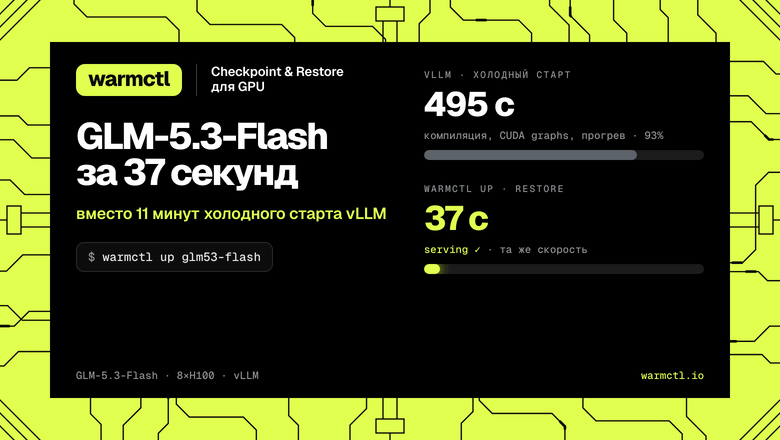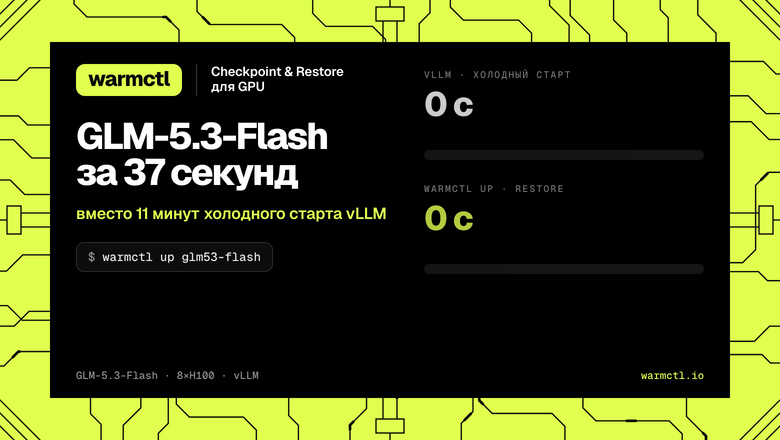
Оптимизация холодного старта vLLM: собираем прогретый OCI образ Deepseek и GLM и запускаем за 30 секунд
Всем привет! Меня зовут Кирилл, я больше десяти лет разрабатываю облака и инфраструктуру. Но последние пару месяцев в рамках R&D я достаточно много занимаюсь инференсом: платформами для него и оптимизацией всего, что вокруг, в частности проектом Serverless GPU с механиками примерно как у Modal или RunPod FlashBoot. Одна из самых болезненных вещей здесь - холодный старт моделей. Каждый MLOps инженер, кто ждал перезапуск пода с vLLM / SGLang по 30 минут знает о чем я говорю. Это особенно актуально, если вы делаете инференс на нескольких облачных провайдерах и спотовом GPU рынке, где может случиться прерывание vm или контейнера, так что способность быстро запускаться - must have в таких условиях. Хорошие новости - чтобы решить эту проблему около месяца назад я начал работу над open-source проектом warmctl , о нём сегодня в посте. Читать далее