
Погружение в большие языковые модели (часть 1)
Full story
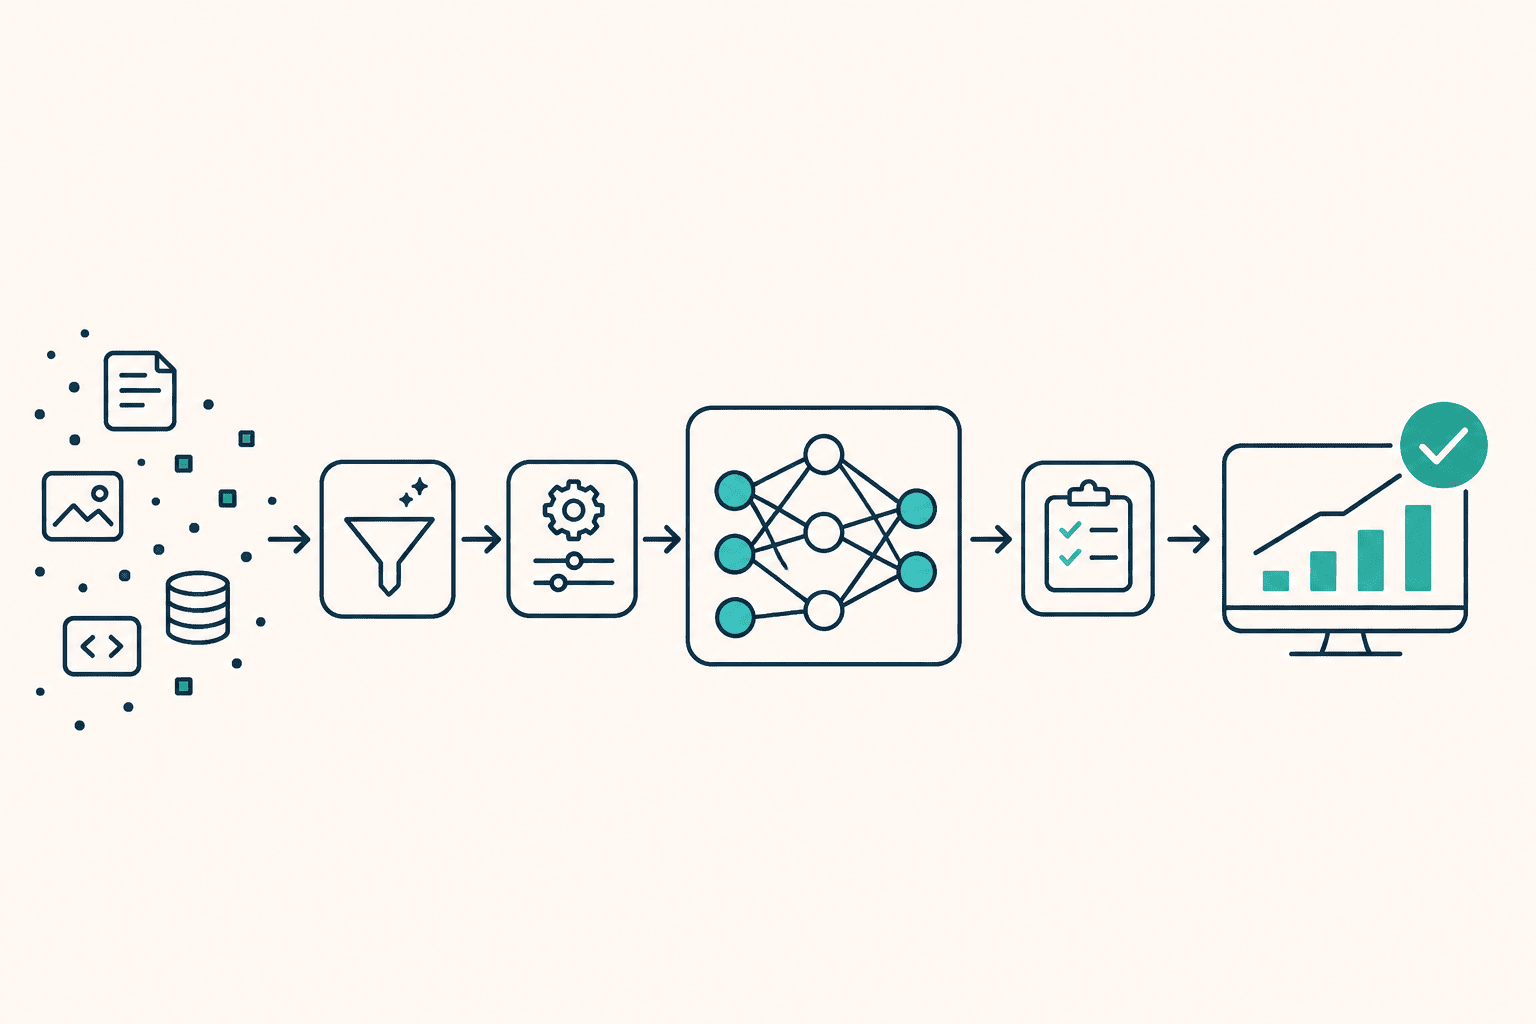
The first part gives a high-level overview of the full lifecycle for developing a machine-learning model, from data collection and preprocessing through algorithm selection, training and quality evaluation. It covers core data-processing methods and current approaches to NLP. It also examines optimization, ways to counter overfitting, and methods for testing models.
В первой части верхнеуровнего рассматривается полный жизненный цикл разработки модели машинного обучения: от сбора и предобработки данных до выбора алгоритма, обучения и оценки качества модели. Разбираются основные методы обработки данных, современные подходы к NLP, способы оптимизации и борьбы с переобучением, а также методы тестирования моделей. Читать далее