
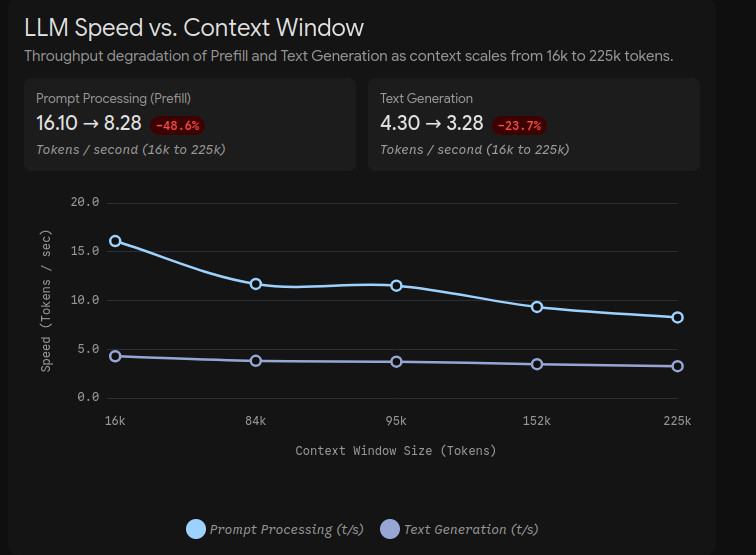
Ускоряем AI модель на процессоре Qwen3.8-Flash-Next Gyro
Существует много различных проектов и вариантов по ускорению генерации AI. Но в большинстве случаев они используют тюнинг модели, а так же использование внешней видео карты. Но можно ли ускорить генерацию модели, если у нас есть только процессор и ОЗУ? Для тестирования использовалась модель Qwen3.8-Flash-Next Gyro GGUF В данной оптимизации помог Opus, который несколько суток гонял тесты на моём железе и пытался оптимизировать код llama. К сожалению мою учётную запись заблокировали, и после верификации и апеляции, окончательно. Возможно ли такой же тюнинг и отладка с другими моделями AI? Читать далее