
Дообучаем Qwen 3.8 122B на 16 ГБ VRAM: SFT и DPO в Strata
The article covers fine-tuning the local Qwen 3.8 model with 122 billion parameters using SFT and DPO in Strata on a GPU with 16 GB of VRAM and 64 GB of RAM. Although the model already runs, it still makes mistakes with numbers, confuses access rights, and loses format in applied tasks when prompts alone are not enough. Because training the whole network on such hardware is impossible, the approach freezes all 48 main layers and runs training dialogues through the GPU once.
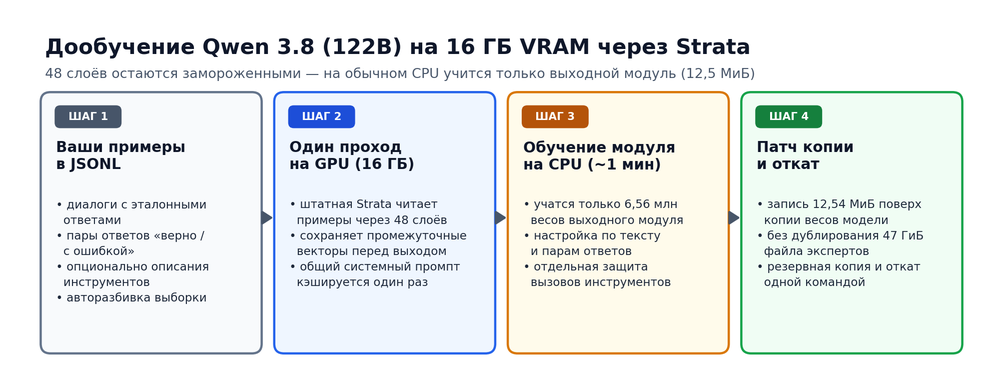
Локальная Qwen 3.8 на 122 миллиарда параметров уже работает в Strata на видеокарте с 16 ГБ памяти и 64 ГБ ОЗУ, но в прикладных задачах всё равно привирает в числах, путает права доступа и сбивается с формата, когда одних промптов уже не хватает. Учить всю сеть на таком железе невозможно — зато можно заморозить все 48 основных слоёв, один раз пропустить обучающие диалоги через видеокарту и за минуту дообучить на обычном процессоре только выходной модуль размером 12,54 МиБ. Под катом — устройство этого узла, готовый скрипт для ваших данных с мгновенным откатом и проверка метода на реальном лабораторном агенте. Как учить 122B-модель на процессоре