Как читать таблицу на 100 млн строк и не положить ни память, ни базу
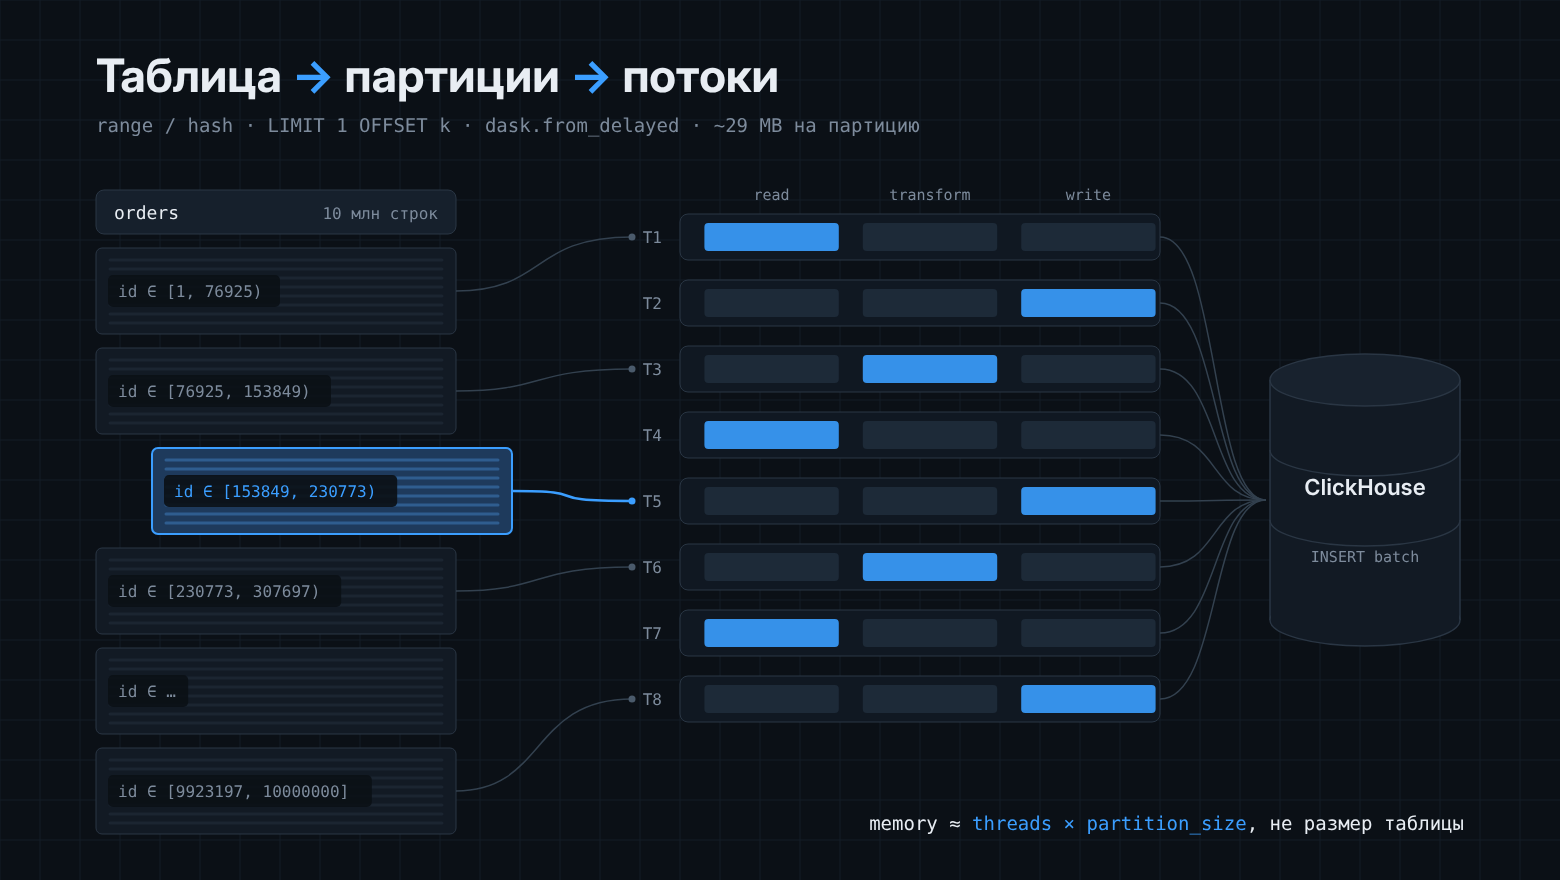
DVT представляет собой платформу визуального ETL с открытым исходным кодом. Пайплайн в ней строится из отдельных узлов: данные сначала считываются, затем проходят преобразования и записываются в место назначения. Автор материала разрабатывает бэкенд DVT и описывает работу одного из его компонентов. Узел чтения должен одинаково обрабатывать таблицы с 10 тысячами и со 100 миллионами строк. Схема рассчитана на шесть СУБД, включая PostgreSQL, MySQL, MariaDB, MS SQL, Oracle, SQLite и ClickHouse. Рабочему выделяется ограниченная память, а нагрузка на источник должна оставаться умеренной. Планировщик core/db/read_v3 сначала оценивает размер строки, а затем рассчитывает необходимое число партиций. Он строит границы range и hash, учитывает стоимость разметки источника и связывает полученные параметры с планированием задач в Dask.
DVT — open-source платформа визуального ETL: пайплайн собирается из нод (чтение → преобразования → запись) и выполняется на воркерах поверх Dask. Я разрабатываю бэкенд DVT, в статье — устройство одного из его компонентов. Нода чтения из БД должна одинаково работать на таблице в 10 тыс. и в 100 млн строк, на шести СУБД (PostgreSQL, MySQL/MariaDB, MS SQL, Oracle, SQLite, ClickHouse), в воркере с ограниченной памятью и без избыточной нагрузки на источник. Ниже — устройство планировщика чтения core/db/read_v3 : оценка размера строки, расчёт числа партиций, построение границ range и hash, стоимость разметки для источника и интеграция с Dask. Читать далее